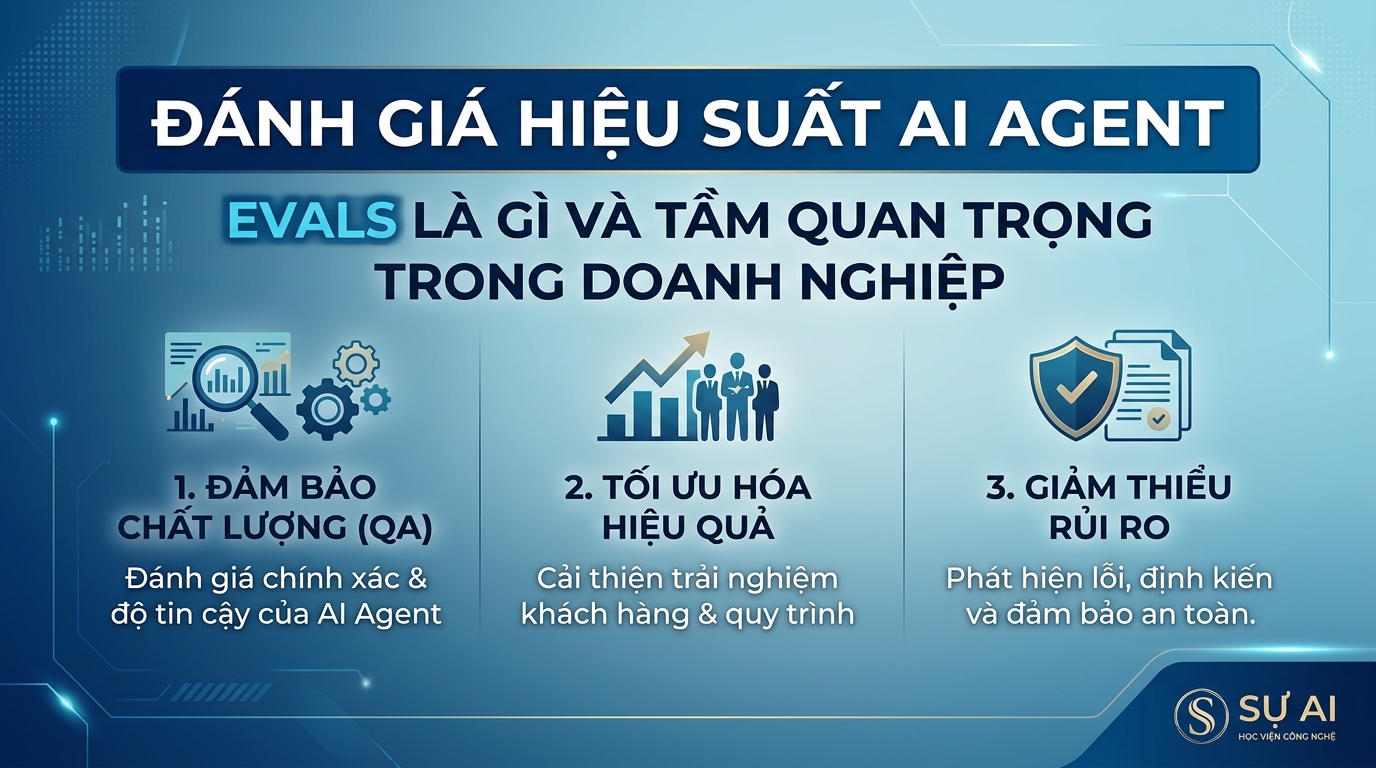
Evals là viết tắt của Evaluations, nghĩa là các quy trình đánh giá được thiết kế để đo lường và định lượng hiệu suất của các AI Agent. Việc đánh giá hiệu suất AI Agent là vô cùng quan trọng đối với doanh nghiệp, giúp đảm bảo các hệ thống AI hoạt động hiệu quả, đáp ứng mục tiêu kinh doanh và mang lại giá trị thực sự. Các builder AI hàng đầu liên tục cải thiện và ‘eval’ các mô hình của họ để đạt được hiệu suất tối ưu.
Evals Là Gì Trong Bối Cảnh AI Agent?
Trong lĩnh vực Trí tuệ Nhân tạo, Evals (Evaluations) là các bài kiểm tra hoặc bộ tiêu chí được sử dụng để đánh giá hiệu quả, độ chính xác, tốc độ và các khía cạnh khác của một mô hình AI hoặc AI Agent. Mục tiêu chính là cung cấp một cái nhìn khách quan về khả năng của AI so với các tiêu chuẩn đã đặt ra hoặc so với các mô hình khác.
Các AI Agent hiện đại ngày càng phức tạp, không chỉ đơn thuần phản hồi một prompt. Thariq từ Anthropic nhấn mạnh rằng việc ‘chỉ cho bạn prompt của họ’ là gần như không thể, vì mọi thứ xoay quanh các tham chiếu, kỹ năng và ví dụ. Ông cho biết thường yêu cầu agent của mình xem xét 3 kho lưu trữ khác, tìm kiếm trên web và sử dụng các API AI khác xem nguồn. Điều này làm cho việc đánh giá trở nên phức tạp hơn, đòi hỏi các ‘eval’ toàn diện để thực sự hiểu khả năng của chúng.
Vì Sao Cần Đánh Giá Hiệu Suất AI Agent Trong Doanh Nghiệp?
Việc triển khai AI Agent trong doanh nghiệp không chỉ là xu hướng mà còn là khoản đầu tư chiến lược. Để khoản đầu tư này thực sự sinh lời, việc đánh giá hiệu suất AI Agent định kỳ là bắt buộc. Điều này giúp doanh nghiệp:
- Đảm bảo chất lượng: Xác minh AI Agent cung cấp kết quả chính xác và đáng tin cậy.
- Tối ưu hóa chi phí: So sánh các mô hình để chọn lựa giải pháp hiệu quả về chi phí token và tài nguyên. Thariq cũng đề cập đến những lo ngại về chi phí token khi nói về các luồng công việc phức tạp, và tin rằng Sonnet + Opus 5.5 sẽ giúp trí thông minh đó trở nên ‘rất sẵn có’ xem nguồn.
- Cải thiện liên tục: Xác định các điểm yếu và cơ hội cải tiến.
- Duy trì lợi thế cạnh tranh: Trong bối cảnh có nhiều đối thủ liên tục thúc đẩy ranh giới AI, như Peter Yang nhận định ‘có 2 (và sớm hơn) đối thủ đang thúc đẩy ranh giới để tất cả chúng ta cùng có lợi’ xem nguồn, việc đánh giá giúp doanh nghiệp luôn đi đầu.
Các Chỉ Số Quan Trọng Khi Đánh Giá Hiệu Suất AI Agent
Khi tiến hành đánh giá hiệu suất AI Agent, có một số chỉ số chính mà doanh nghiệp cần tập trung:
- Tốc độ xử lý (Speed): AI Agent có thể hoàn thành tác vụ nhanh đến mức nào? Boris Cherny từ Anthropic thông báo Sonnet 5.5 nhanh hơn 30% xem nguồn. Cat Wu, cũng từ Anthropic, bổ sung rằng Sonnet 5.5 nhanh hơn Sonnet 5 tới 24 giây trong một tác vụ cụ thể, đồng thời giúp hoàn thành ‘nhiều hơn ~30% tác vụ’ so với Sonnet 5 xem nguồn.
- Hiệu quả tài nguyên (Resource Efficiency): AI Agent tiêu thụ bao nhiêu tài nguyên (ví dụ: token, năng lượng) để hoàn thành một tác vụ? Sonnet 5.5 sử dụng ít hơn 30% tài nguyên (Boris Cherny) xem nguồn, và 6K token ít hơn cho cùng một công việc (Cat Wu) xem nguồn.
- Độ chính xác và chất lượng đầu ra (Accuracy & Output Quality): Kết quả do AI Agent tạo ra có đúng, hữu ích và đạt tiêu chuẩn chất lượng mong muốn không? Alex Albert từ Anthropic cũng cảm nhận Sonnet 5.5 ‘viết rõ ràng’ và là ‘bước nhảy vọt lớn về khả năng’ so với Sonnet 5 xem nguồn.
- Khả năng xử lý tác vụ phức tạp (Complex Task Capability): AI Agent có thể xử lý các yêu cầu đa bước, nhiều tham chiếu không? Đây là một thước đo quan trọng cho các AI Agent thế hệ mới.
Các Ví Dụ Thực Tế Về Đánh Giá Hiệu Suất AI Agent
Các công ty hàng đầu đã và đang thực hiện các đánh giá hiệu suất chi tiết để tối ưu hóa việc sử dụng AI Agent. Đây là minh chứng rõ ràng cho tầm quan trọng của Evals:
Đánh giá Hiệu Suất AI Agent tại Box với Sonnet 5.5
Aaron Levie, CEO của Box, chia sẻ rằng họ đã thử nghiệm Sonnet 5.5 trên ‘eval công việc phức tạp’ với Box Agent. Kết quả cho thấy Sonnet 5.5 là một bước nhảy vọt đáng kể từ Sonnet 5 trong công việc tri thức với nội dung doanh nghiệp. Box ghi nhận sự cải thiện tổng thể 4 điểm trên các bài kiểm tra khó nhất của họ, và đặc biệt là ‘nhanh hơn khoảng 2.4 lần để hoàn thành công việc’ với ‘ít hơn 12% token’.
Hơn nữa, Box còn thấy những ‘thắng lợi lớn’ trong các lĩnh vực cụ thể:
- Dịch vụ Tài chính: Cải thiện +18 điểm phần trăm
- Pháp lý: Cải thiện +7 điểm phần trăm
- Khoa học Đời sống: Cải thiện +8 điểm phần trăm
- Khu vực Công: Cải thiện +7 điểm phần trăm
Những số liệu này cho thấy sức mạnh của việc đánh giá chi tiết để hiểu rõ giá trị mà một AI Agent mới mang lại xem nguồn.
Đánh giá Hiệu Suất AI Agent tại Every của Dan Shipper
Dan Shipper, CEO của Every, cũng thực hiện các bài kiểm tra chuyên sâu. Ông nhận thấy Sonnet 5.5 ‘cải thiện đáng kể khả năng viết’ so với Opus 5.5 và ‘đánh bại nó ở các tác vụ chỉnh sửa’. Đối với ông, Sonnet 5.5 ‘nhanh hơn và rẻ hơn’ Opus 5.5, trở thành mô hình được ưa thích cho công việc mã hóa và thiết kế lặp nhanh. Dan Shipper còn chia sẻ điểm số của Sonnet so với Opus và Astra trên ‘bài benchmark cá nhân’ của mình, được rút ra từ công việc thực tế xem nguồn. Điều này minh chứng cho cách các doanh nghiệp tận dụng Evals để lựa chọn mô hình phù hợp nhất với nhu cầu cụ thể.
Tương Lai Của Việc Đánh Giá AI Agent
Khi các AI Agent ngày càng trở nên tự chủ và có khả năng tương tác với nhiều hệ thống, việc đánh giá chúng cũng sẽ phức tạp hơn. Thariq đã chỉ ra rằng việc tương tác với agent hiện nay đòi hỏi agent phải ‘xem xét 3 kho lưu trữ khác, tìm kiếm trên web để tham khảo, sử dụng các API AI khác’, chứ không chỉ là một prompt đơn lẻ xem nguồn. Điều này đòi hỏi các Evals phải mô phỏng các kịch bản thực tế phức tạp hơn, kiểm tra khả năng suy luận, lập kế hoạch và thực hiện nhiều bước.
Việc liên tục cải thiện và ‘eval’ các mô hình là một cuộc đua không ngừng giữa các nhà phát triển. Điều này đảm bảo rằng các doanh nghiệp sẽ luôn có những lựa chọn tốt hơn, nhưng đồng thời cũng đặt ra thách thức về việc làm sao để liên tục đo lường và tích hợp những công nghệ tiên tiến nhất một cách hiệu quả.
Tóm lại, Evals là công cụ không thể thiếu để đo lường và cải thiện hiệu suất AI Agent. Đối với doanh nghiệp, việc đầu tư vào các quy trình đánh giá hiệu suất AI Agent không chỉ là kiểm tra chất lượng mà còn là động lực để tối ưu hóa hoạt động, tiết kiệm chi phí và giữ vững vị thế dẫn đầu trong kỷ nguyên AI. Doanh nghiệp bạn cần bắt đầu xây dựng khung đánh giá hiệu suất AI Agent ngay hôm nay để tối ưu hóa đầu tư và duy trì lợi thế cạnh tranh.